

Gdy „dobry” bot ubija sklep PrestaShop
Case study optymalizacji PrestaShop: boty, filtry i integracja przeciążały bazę danych i dawały błędy 500. Diagnoza z logów, reguły .htaccess i efekty.
Przeczytaj
Case study · optymalizacja PrestaShop
W skrócieCase study z dwóch analiz przeciążenia serwera. Oba sklepy PrestaShop miały ten sam objaw: skoki obciążenia procesora i bazy danych, błędy 500 i przestoje. W żadnym z nich nie było ataku DDoS ani awarii hostingu.
Ten sam case w dwóch wersjach. Prosta tłumaczy, co się działo i co z tym zrobić. Wersja dla zaawansowanych pokazuje logi, kody odpowiedzi, zapytania API oraz gotowe reguły .htaccess i robots.txt.
Liczby z analizy
14%
żądań obsługiwanych przez PHP pochodziło od klientów sklepu
4-5 mln
zapytań do bazy dziennie generowała jedna integracja: BaseLinker
5,6 tys.
kombinacji filtrów przeszedł bot SEO w ciągu tygodnia
494
błędy 500 w trzy minuty jednej serii bota
Sklepy z tego case study
Przypadek 1 · pułapka indeksacyjna
Części do samochodów ciężarowych i dostawczych, sklep w dwóch językach i dwóch walutach. Przełącznik języka i waluty tworzył robotom nieskończone adresy.
Przypadek 2 · integracja, bot SEO i scraper
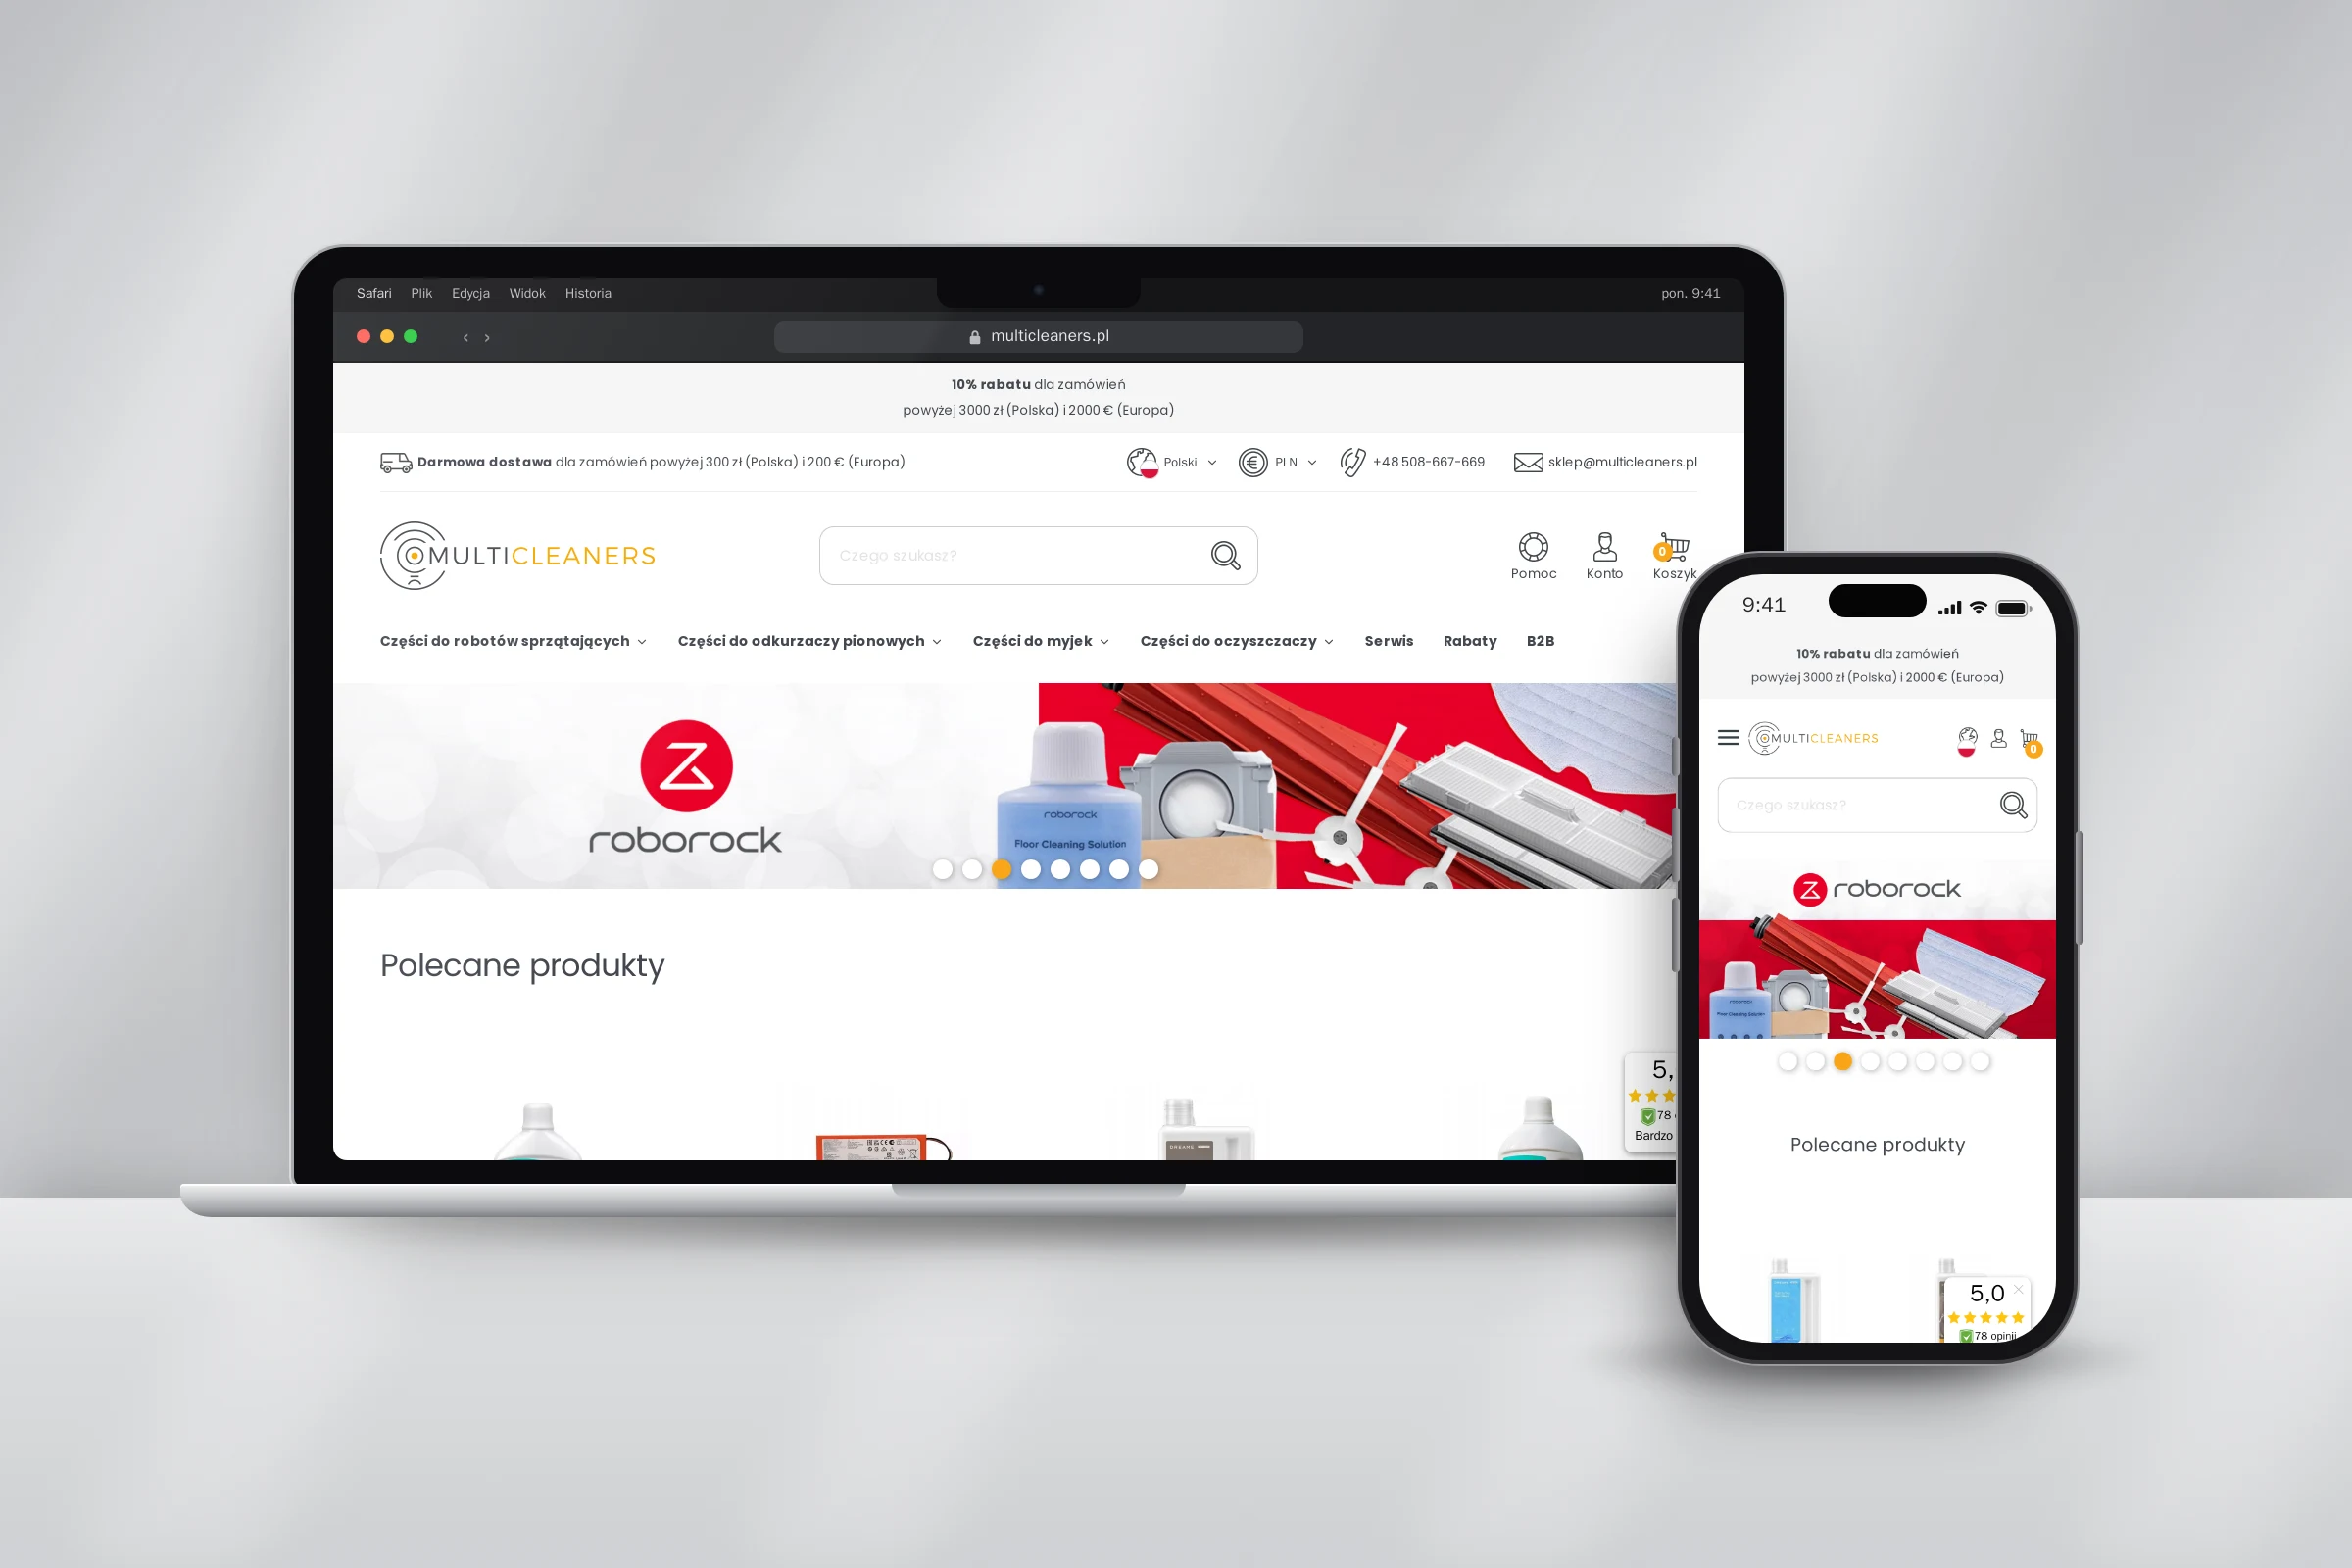
Oryginalne części do robotów sprzątających i odkurzaczy, PrestaShop 8 i zamówienia w BaseLinkerze. Integracja, bot SEO w filtrach i scraper naraz.
Czytasz wersję prostąZmień na wersję dla zaawansowanych ↑
Dwa sklepy na PrestaShop, ten sam problem. Na co dzień wszystko działało, ale co jakiś czas sklep nagle zwalniał, pokazywał klientom stronę błędu, czyli tak zwany błąd 500, a hosting alarmował o przeciążeniu bazy danych. Pierwsza myśl: atak hakerski albo za słaby serwer. Prawda była inna.
Sklepy przeciążały automaty: roboty wyszukiwarek, narzędzia do analizy SEO, integracje z innymi systemami i programy kopiujące dane. W Google Analytics ich nie widać, bo to nie ludzie. A potrafią zlecić sklepowi więcej pracy niż wszyscy klienci razem.
W jednym ze sklepów klienci odpowiadali tylko za około 14% pracy, którą wykonywał sklep. Resztę zlecały automaty.
Wyobraź sobie restaurację. Zdjęcia i wygląd strony to napoje z lodówki: podaje się je od ręki, bez udziału kuchni. Ale strona kategorii, wynik wyszukiwania czy lista z filtrami to danie gotowane od zera. Sklep musi sprawdzić ceny, promocje i dostępność, zapytać bazę danych i ułożyć wszystko w całość.
Na tańszym hostingu kuchnia ma z góry określoną liczbę stanowisk. Gdy robot zamawia setki takich dań na minutę, kuchnia się zapycha. Kolejny gość, także prawdziwy klient, słyszy: dziś nie obsłużymy. To właśnie błąd 500.
Pierwszy przypadek to Optima Cars, sklep z częściami do samochodów ciężarowych i dostawczych, który działa w dwóch językach i dwóch walutach. Sklep przeciążał robot dużej platformy społecznościowej. Nie atakował sklepu. Po prostu chodził po linkach, które sklep sam mu podsuwał.
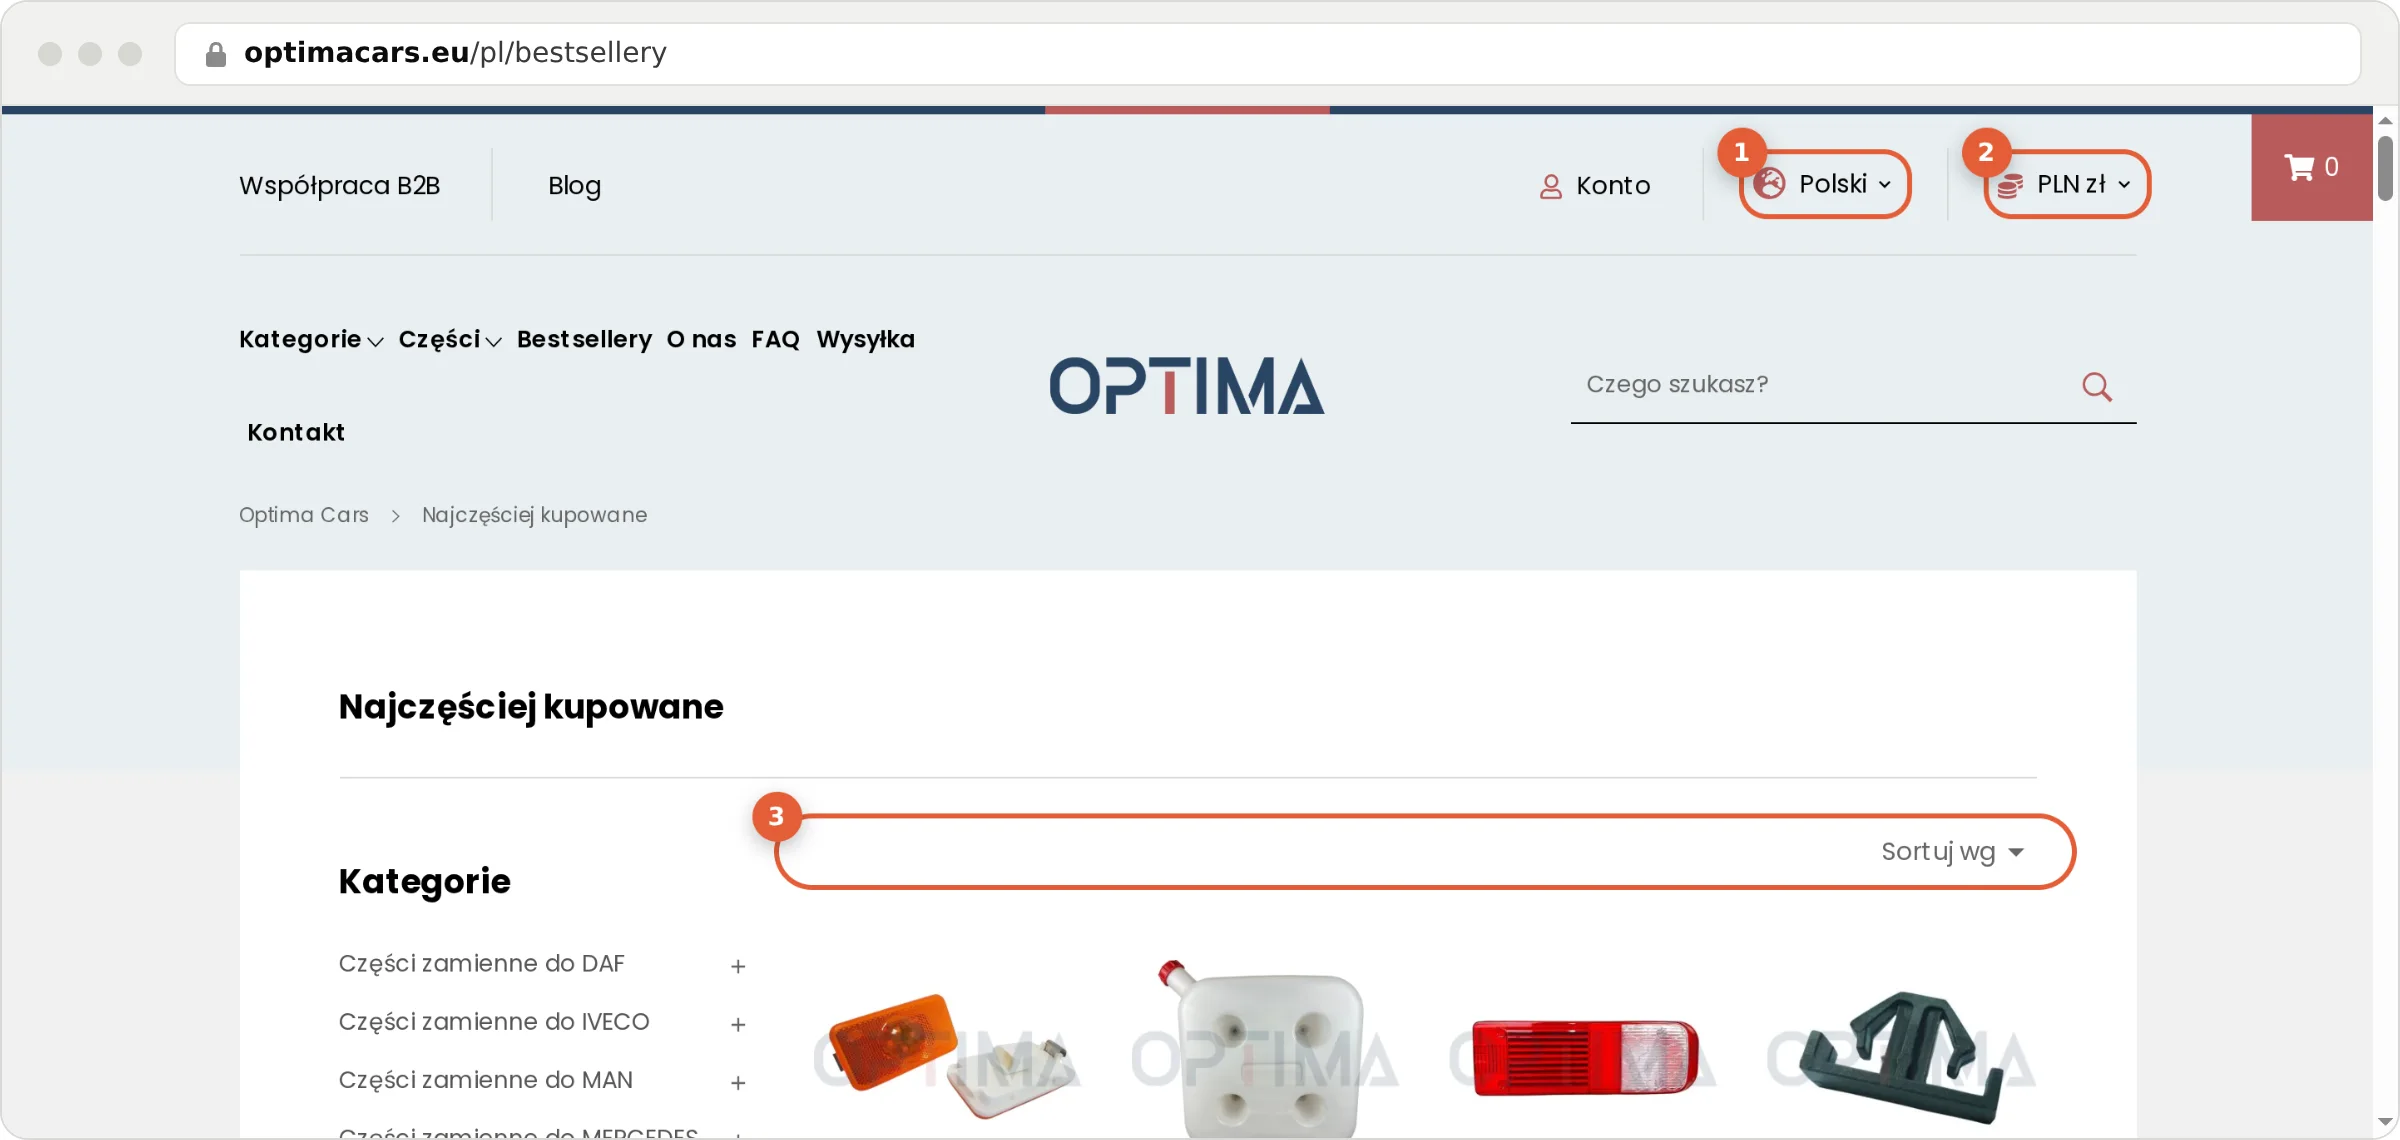
Błąd siedział w przełączniku języka i waluty. Każde kliknięcie dopisywało do adresu strony kolejny fragment, zamiast podmienić poprzedni. Adres rósł bez końca, a dla robota każdy dłuższy adres był nową stroną do odwiedzenia. Sklep sam zbudował labirynt bez wyjścia.
Najbardziej oberwała strona bestsellerów, bo można ją sortować i dzielić na strony na dziesiątki sposobów. Kilkadziesiąt tysięcy wejść robota oznaczało tyle samo pełnych przeliczeń sklepu: cen, rabatów i zapytań do bazy danych.
Drugi przypadek to Multicleaners, sklep z oryginalnymi częściami do robotów sprzątających i odkurzaczy. Właściciel widział tylko tyle, że co jakiś czas baza danych się przeciąża. Przejrzeliśmy tydzień zapisów z serwera, około 190 tysięcy wejść, i sprawdziliśmy, kto naprawdę zleca sklepowi pracę.
Integracja z BaseLinkerem (dziś Base, base.com), systemem do obsługi zamówień, pytała sklep o zamówienia mniej więcej co 80 sekund, dzień i noc. Za każdym razem prosiła o całą historię, choć potrzebowała tylko nowych. To tak, jakby kurier co półtorej minuty prosił o wydruk wszystkich zamówień od założenia firmy. Dla bazy danych oznaczało to kilka milionów zapytań dziennie, i to coraz więcej z każdym nowym zamówieniem.
Zgłosiliśmy to do supportu BaseLinkera. Nie udało się za pierwszym razem: pierwsze dwie osoby z supportu nie bardzo wiedziały, o co chodzi, i odpowiadały tylko twierdząco albo przecząco. Dopiero kolejne zgłoszenie, poparte konkretnymi danymi z logów, trafiło do kogoś, kto zmienił ustawienia. Teraz integracja zagląda do sklepu co około 10 minut, a liczba jej zapytań spadła mniej więcej trzykrotnie.
Wskazówka: zgłaszając taki problem, od razu podaj liczby. Ile razy na dobę integracja pyta sklep, o co dokładnie prosi i ile zapytań do bazy to kosztuje. Na ogólne pytanie łatwo dostać ogólną odpowiedź.
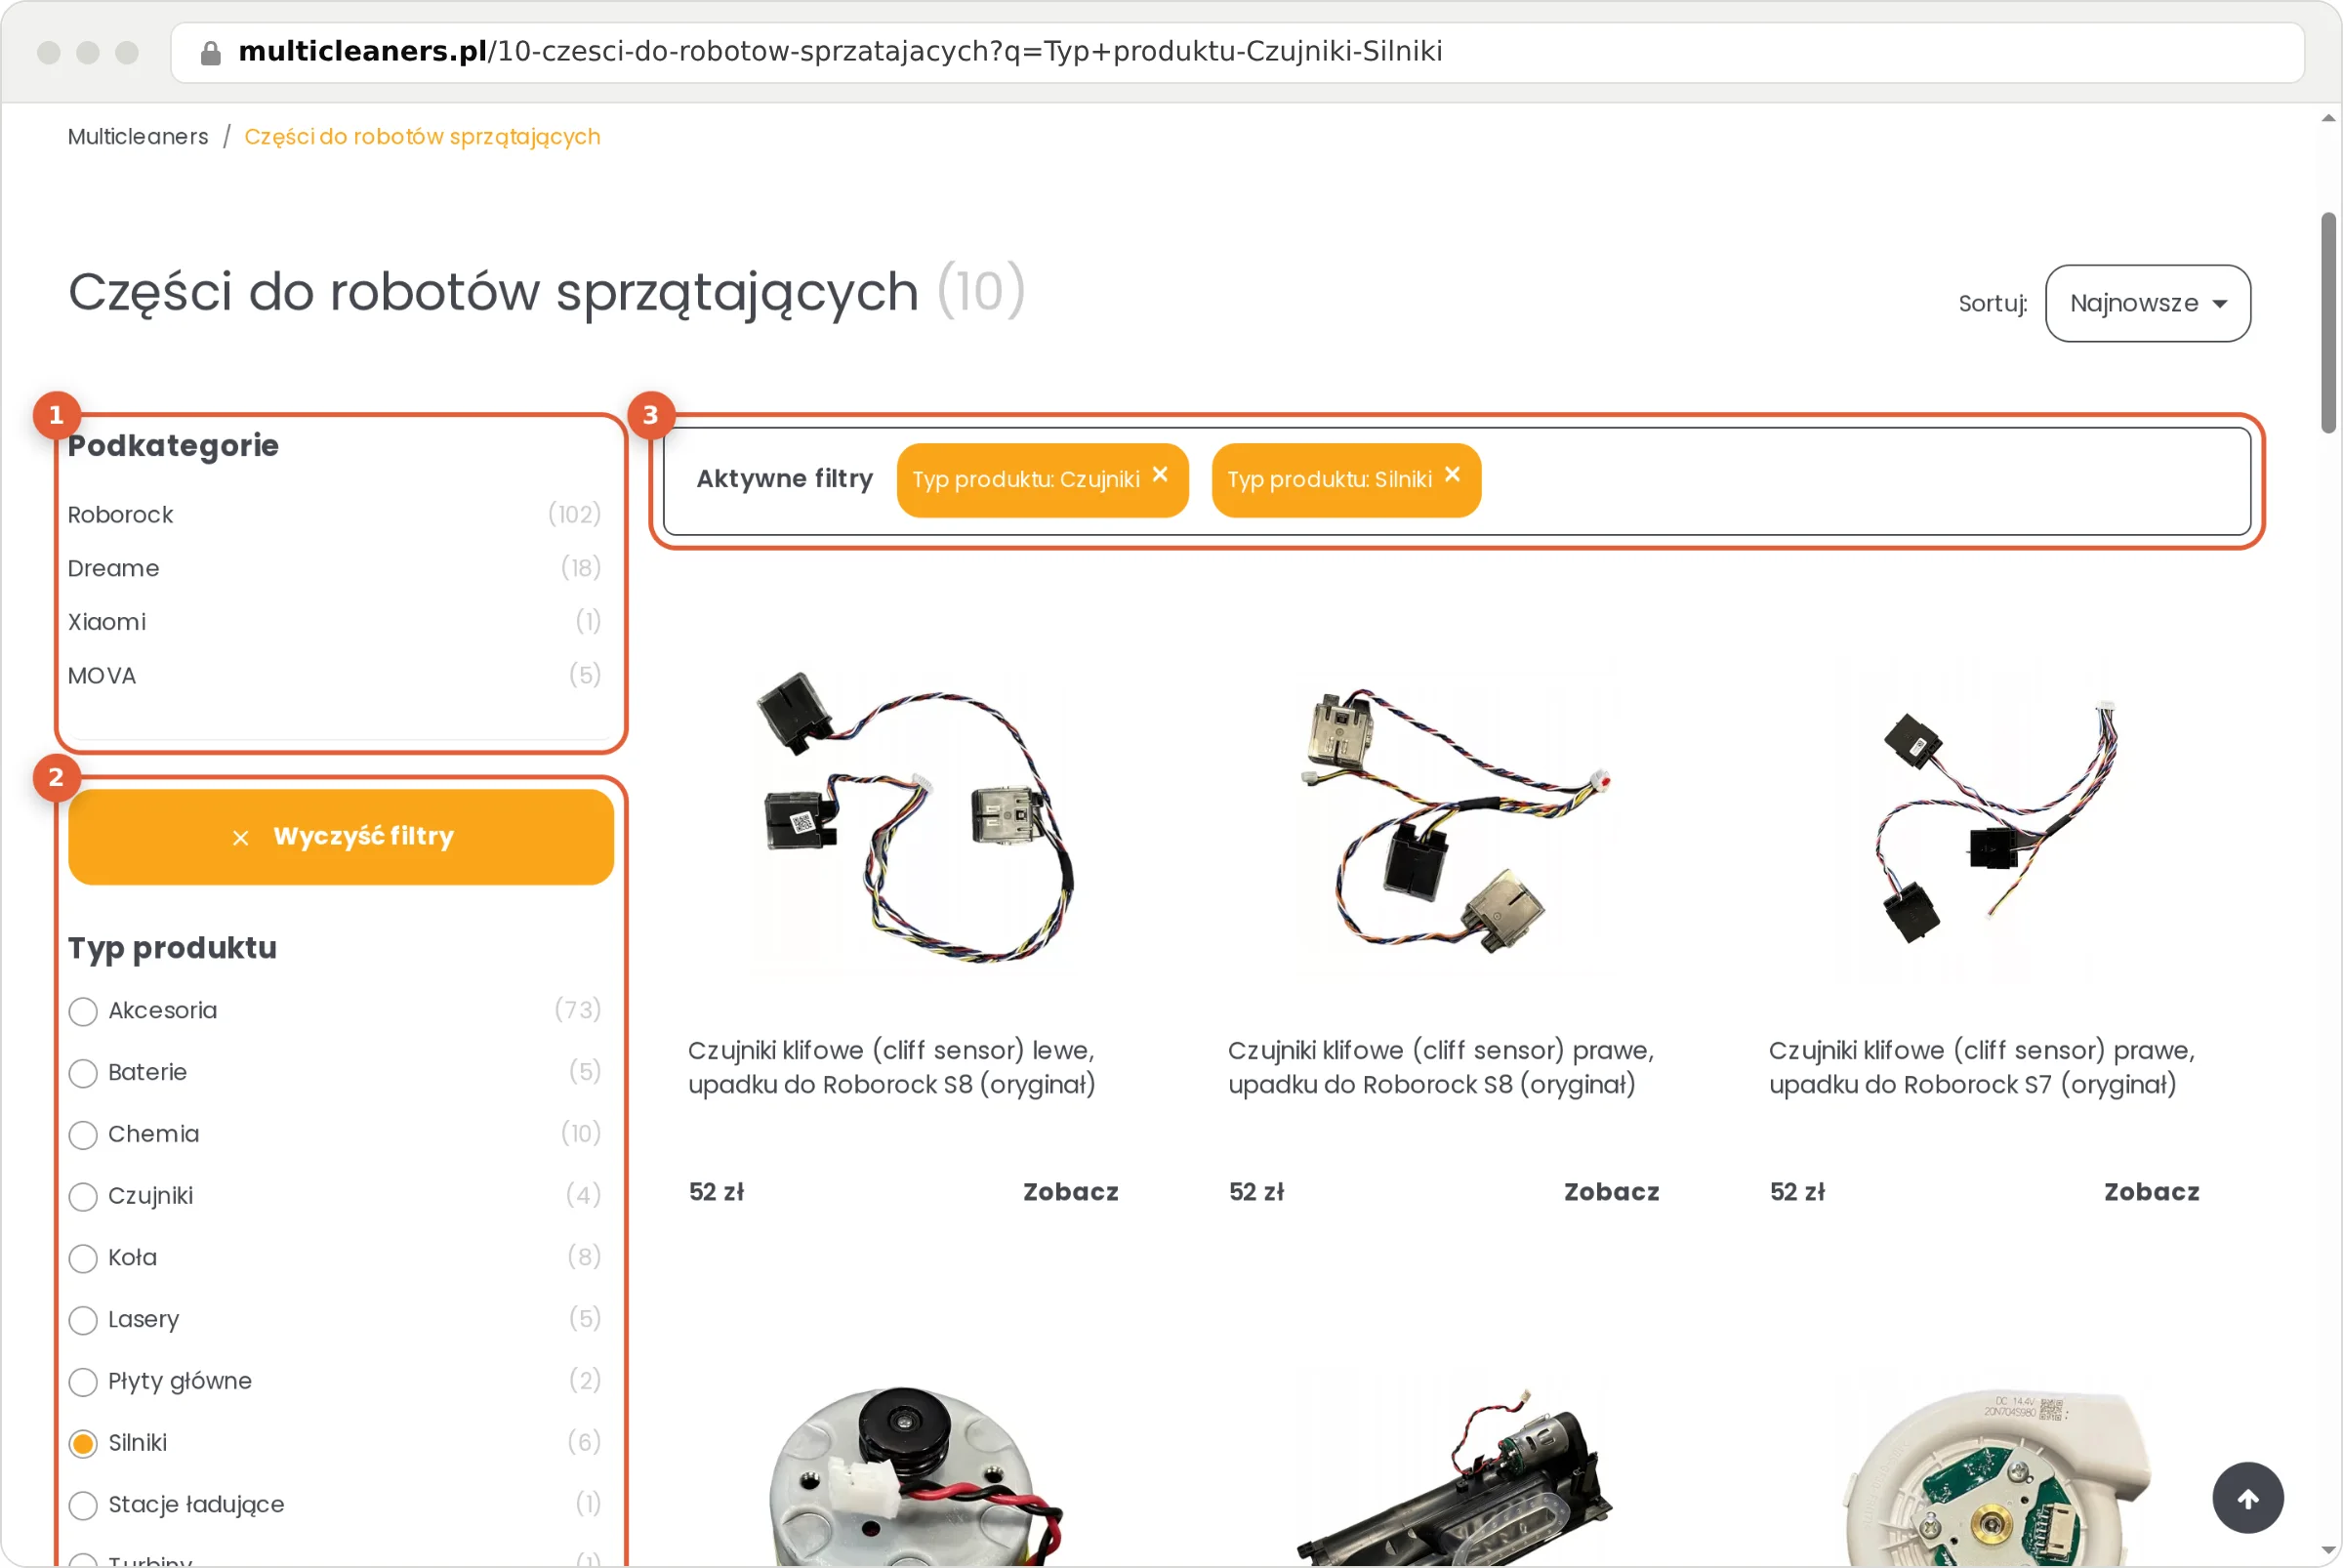
Robot narzędzia do analizy linków przeklikiwał filtry: marka, model, typ części i kolejne strony wyników. W tydzień odwiedził 5,6 tysiąca różnych kombinacji. Filtry to najcięższe strony sklepu, bo przy każdej sklep przelicza, ile produktów pasuje do każdej opcji. Gdy robot przyspieszył do kilku stron na sekundę, po czterech minutach sklep zaczął pokazywać błędy.
Najbardziej podstępny był program, który kopiował dane ze sklepu i podszywał się pod zwykłego użytkownika przeglądarki Chrome. Osiem adresów naraz, około 200 stron na minutę. Po sześciu minutach błędy zobaczyli też prawdziwi klienci i robot Google. Takiego gościa nie zatrzyma prośba w pliku robots.txt, bo on jej po prostu nie czyta.
Nie zaczęliśmy od droższego serwera. Najpierw odcięliśmy pracę, której klienci w ogóle nie potrzebowali.
Jak to zwykle bywało
Co zmieniliśmy · jak jest teraz
31%
mniej żądań, które uruchamiają PrestaShop
93%
mniej wejść w strony z filtrami
0
zablokowanych klientów i zamówień z integracji
1400 z 1411
żądań odciętych w serii, która wcześniej kończyła się błędami
Jeśli rozpoznajesz u siebie dwa albo trzy z nich, zanim zapłacisz za większy serwer, warto zajrzeć do logów. Zrobimy to za Ciebie i pokażemy, co realnie obciąża sklep. Zobacz też, jak budujemy i rozwijamy sklepy internetowe.
Najważniejsze pytanie nie brzmi: który robot wszedł do sklepu. Brzmi: dlaczego sklep dał mu tyle pracy i ile z tej pracy było potrzebne klientom?
Chcesz szczegółów: logów, kodów odpowiedzi i gotowych reguł .htaccess?Przełącz na wersję dla zaawansowanych ↑
Czytasz wersję dla zaawansowanychZmień na wersję prostą ↑
Nagły wzrost użycia procesora i bazy danych nie zawsze oznacza atak, awarię hostingu albo źle wykonaną aktualizację PrestaShop. Czasami wystarczy legalny robot indeksujący i jeden błędnie wygenerowany link, żeby sklep sam stworzył mu praktycznie nieskończoną liczbę adresów URL. Innym razem przyczyną jest integracja, która co chwilę czyta całą historię zamówień, albo bot SEO, który przeklikuje każdą kombinację filtrów.
Poniżej opisujemy dwa przypadki z naszej pracy przy optymalizacji sklepów PrestaShop. W obu sklep działał poprawnie dla klientów, a mimo to okresowo dławił się pod ruchem, którego w Google Analytics w ogóle nie widać.
W jednym ze sklepów przeglądarki klientów odpowiadały za około 14% żądań obsługiwanych przez PHP. Resztę generowały integracje, boty i automaty.
Zdjęcia, pliki CSS i JavaScript serwuje sam serwer WWW, bez udziału bazy danych. Kosztowne są żądania dynamiczne: strony kategorii i produktów, filtry, wyszukiwarka, koszyk, panel administracyjny i API. Każde takie żądanie uruchamia:
Dlatego w analizie nie liczymy wizyt, tylko żądania dynamiczne, i sprawdzamy, kto je wysyła. Na hostingu współdzielonym liczba jednoczesnych procesów PHP i połączeń z bazą jest ograniczona. Gdy się wyczerpie, PrestaShop nie może połączyć się z bazą i zwraca błąd 500. Klient widzi stronę błędu, choć serwer formalnie działa.
Sklep działał poprawnie dla użytkowników, ale okresowo zużycie procesora i pracy bazy danych rosło wielokrotnie. Hosting raportował setki gigabajtów operacji bazodanowych, pojawiały się błędy 500, a sklep zaliczał przestoje. To sklep Optima Cars z częściami do samochodów ciężarowych i dostawczych, który działa w dwóch językach i dwóch walutach.
Naturalnym podejrzanym były narzędzia SEO. Wcześniej w logach pojawiały się crawlery takie jak Ahrefs, więc łatwo było założyć, że kolejna analiza SEO znów przeciążyła sklep. Logi pokazały jednak coś innego:
To nie był klasyczny atak. Bot konsekwentnie podążał za linkami, które wygenerował sam sklep.
Źródłem problemu okazało się połączenie selektora języka i waluty. Zmiana języka generowała adres, który zawierał już parametry, a szablon doklejał kolejne po następnym znaku ?, zamiast połączyć je przez &. Powstawały adresy takie jak:
/lista-produktow?order=price&page=5?zmiana_waluty=1Po zakodowaniu adresu i kolejnym przejściu przez przełącznik języka lub waluty parametr trafiał do URL-a jeszcze raz:
/lista-produktow?...%3Fzmiana_waluty%3D1...%3Fzmiana_waluty%3D1...Niektóre adresy zawierały ten sam parametr dziesiątki, a nawet setki razy. Dla robota każdy z nich był nową stroną. Tak powstała pułapka indeksacyjna, po której crawler mógł chodzić praktycznie bez końca.
Najwięcej zapytań trafiało na stronę bestsellerów i jej warianty:
Jedno wejście na stronę bestsellerów nie jest problemem. Kilkadziesiąt tysięcy wejść na unikalne warianty tej samej strony to tyle samo pełnych uruchomień PrestaShop, z liczeniem cen, sortowaniem i zapytaniami do bazy. Setki gigabajtów raportowane przez hosting nie oznaczały, że baza tyle waży. To suma danych odczytanych i przetworzonych przez powtarzające się zapytania.
Log błędów urósł w ciągu jednego dnia do setek megabajtów. Zdecydowaną większość stanowiły komunikaty Deprecated generowane przez starsze moduły po aktualizacji PrestaShop lub PHP. Same deprecjacje zwykle nie psują sklepu, ale:
W tym szumie kryły się rzeczywiste błędy 500. Powstawały, gdy zniekształcony URL trafiał do parsera sortowania, a kierunek sortowania wyglądał na przykład tak:
asc?zmiana_waluty=1PrestaShop oczekiwał wartości asc albo desc, więc odrzucał taki parametr wyjątkiem.
410 Gone. Ten kod mówi robotom, że adres zniknął na stałe i powinien wypaść z kolejki indeksowania.nofollow, żeby roboty nie budowały z nich kolejnych wariantów stron.E_DEPRECATED i E_USER_DEPRECATED, zostawiając ostrzeżenia, błędy i błędy krytyczne. Przestarzałe moduły nadal trzeba poprawić, ale nie powinny generować setek tysięcy identycznych wpisów dziennie.Drugi sklep, Multicleaners z oryginalnymi częściami do robotów sprzątających i odkurzaczy, działa na PrestaShop 8, na hostingu współdzielonym, z historią około 2500 zamówień obsługiwanych w BaseLinkerze (dziś Base, base.com). Właściciel zgłaszał okresowe przeciążenia bazy danych. Przeanalizowaliśmy tydzień logów serwera, około 190 tysięcy żądań, a potem kolejne dni po wprowadzeniu zmian.
Ponad połowa żądań dotyczyła plików statycznych i nie dotykała bazy. Z pozostałych 86 tysięcy żądań, które uruchamiały PrestaShop, tylko niewielka część pochodziła od klientów:
BaseLinker pobierał listę zamówień przez API PrestaShop średnio co 83 sekundy, około 900 razy na dobę. Zapytanie nie miało filtra daty ani statusu, więc sklep za każdym razem zwracał wszystkie zamówienia z historii, choć integracja potrzebowała tylko najnowszych.
83 s
średni odstęp między pobraniami pełnej listy zamówień
900
pobrań listy zamówień na dobę
5000
zapytań do bazy na jedno sprawdzenie, w przybliżeniu
4-5 mln
zapytań do bazy na dobę według naszego szacunku
Kosztowne nie było samo przesłanie listy. Gdy zapytanie do API wskazuje konkretne pola, na przykład display=[id,date_upd,date_add], PrestaShop dla każdego wiersza tworzy pełny obiekt zamówienia, a konstruktor zamówienia wczytuje dodatkowo klienta. To około dwóch zapytań na zamówienie, czyli około 5000 zapytań na jedno sprawdzenie. Według naszego szacunku dawało to od 4 do 5 milionów zapytań na dobę, a koszt rósł z każdym nowym zamówieniem.
Druga rzecz: każde nowe zamówienie integracja pobierała w całości co minutę przez około trzy godziny. Jedno z nich zostało pobrane 163 razy, za każdym razem z klientem, adresem, pozycjami, płatnościami i stanami magazynowymi, czyli 11 lub 12 zapytaniami do API.
Co się zmieniło. Korekta wymagała kilku zgłoszeń do supportu BaseLinkera. Pierwsze dwie osoby nie bardzo wiedziały, o co chodzi, i odpowiadały tylko twierdząco albo przecząco, bez odniesienia do przesłanych danych. Dopiero kolejna rozmowa, z konkretnymi danymi z logów: częstotliwością pobierania, brakiem filtra daty i statusu oraz 163 pobraniami jednego zamówienia, doprowadziła do zmiany. Integracja zaczęła odpytywać sklep co około 10 minut, a minutowe pobieranie nowych zamówień zniknęło. Liczba żądań API spadła około trzykrotnie, a liczba pobrań pełnej listy zamówień sześciokrotnie. Kolejnym krokiem jest filtr statusów w ustawieniach zaawansowanych integracji. API PrestaShop obsługuje wykluczenia, na przykład:
current_state=![5|6|7]Taki filtr pomija zamówienia dostarczone, anulowane i zwrócone. Wykluczanie jest bezpieczniejsze niż lista dozwolonych statusów, bo zamówienie w nowym, nieprzewidzianym statusie i tak trafi do integracji.
Wniosek jest prosty: integracje to też ruch. Z perspektywy zewnętrznego systemu pobranie całej listy jest tanie. Dla sklepu każde takie wywołanie to tysiące zapytań do bazy. Zgłaszając taki problem do supportu integracji, warto od razu podać liczby: wywołania na dobę, odstępy, parametry zapytań i przykładowe wpisy z logów. Bez nich łatwo o odpowiedź „tak” albo „nie”, która niczego nie zmienia.
MJ12bot, crawler narzędzia Majestic, odpowiadał za 17% żądań do PHP i odwiedzał prawie wyłącznie strony z filtrami. W ciągu tygodnia przeszedł 5,6 tysiąca unikalnych kombinacji, łącząc od dwóch do pięciu grup filtrów z paginacją:
/kategoria?q=Marka-X/Model-Y/Typ-produktu-Z&page=2Strony z filtrami to najcięższe strony PrestaShop. Moduł filtrów przy każdej z nich liczy produkty dla każdej wartości każdego filtra, a przy tylu unikalnych kombinacjach cache niewiele pomaga. Domyślny robots.txt generowany przez PrestaShop nie blokuje parametru q=, więc bot, który respektuje robots.txt, nie miał powodu omijać filtrów.
Przez kilka tygodni był to stały, uciążliwy ruch. Potem przyszła seria:
Wcześniej ten sam efekt dał automat, który nie przedstawiał się jako bot. Osiem adresów IP z serwerowni, każdy z ośmioma zmienianymi nagłówkami przeglądarki Chrome, przez 10 minut przeglądało filtry z prędkością około 200 stron na minutę. Po sześciu minutach sklep zaczął zwracać błędy 500, łącznie 554 w cztery minuty. Ucierpieli też klienci: w tych minutach błąd dostało 12 z 33 odsłon wykonanych przez innych odwiedzających, a także Googlebot.
Takiego ruchu nie zatrzyma blokada po nazwie bota ani robots.txt. Potrzebne jest ograniczanie liczby żądań z jednego adresu, WAF albo CDN, a tego na hostingu współdzielonym zwykle nie da się ustawić bez zewnętrznej usługi.
Logi HTTP nie pokazują zapytań SQL, więc szukaliśmy pośrednich śladów. Wszystkie błędy 500 miały dokładnie 2506 bajtów, czyli tyle, ile strona error500.html, którą PrestaShop pokazuje przy nieobsłużonym wyjątku, najczęściej przy braku połączenia z bazą. Błędy pojawiały się zawsze kilka minut po rozpoczęciu serii i znikały razem z nią. Rozmiar odpowiedzi jako odcisk palca błędu to prosta i skuteczna metoda, gdy nie ma dostępu do logów bazy.
/koszyk.html?del=N?del=N. To ten sam wzorzec co w pierwszym przypadku: podwojony znak ? tworzy adres, który dla robota zawsze wygląda na nowy.Reguły trafiły nad znacznik # ~~start~~, bo PrestaShop przy ponownym generowaniu pliku zachowuje wszystko, co jest poza nim.
# Blokada botów obciążających bazę (nad znacznikiem ~~start~~)
<IfModule mod_rewrite.c>
RewriteEngine on
# Wybrane boty: 403 na wszystko oprócz robots.txt
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (MJ12bot|DotBot) [NC]
RewriteRule ^ - [F,L]
# Strony z filtrami (?q=): 403 dla robotów, klienci bez zmian
RewriteCond %{QUERY_STRING} (^|&)q= [NC]
RewriteCond %{HTTP_USER_AGENT} compatible;[^)]*(bot|crawl|spider) [NC]
RewriteRule ^ - [F,L]
</IfModule>
Pierwsza reguła całkowicie odcina wybrane boty, ale zostawia im robots.txt, żeby przeczytały zakaz i przestały wracać. Druga odcina od filtrów roboty, które przedstawiają się wzorem compatible; …bot, a kategorie i produkty zostawia im otwarte. Wzorzec jest celowo wąski, bo samo słowo „bot” występuje też w nazwach niektórych telefonów i integracji.
# w sekcji User-agent: *
Disallow: /*?q=
Disallow: /*&q=
Disallow: /koszyk
Disallow: /zamowienie

User-agent: MJ12bot
Disallow: /

User-agent: DotBot
Disallow: /
Przycisk „Generuj robots.txt” w panelu PrestaShop nadpisuje ręczne wpisy, więc po jego użyciu trzeba je dodać ponownie.
Jeśli w .htaccess jest ErrorDocument 403 kierujący do PHP, zablokowane żądanie i tak uruchomi PrestaShop. W tym sklepie takiej reguły nie było. Odpowiedź 403 zwraca sam Apache: 199 bajtów w około 0,25 sekundy, podczas gdy zwykła strona sklepu generuje się około 1,5 sekundy.
Reguły sprawdziliśmy na kopii sklepu w 23 scenariuszach: różne boty, przeglądarki, telefony i integracja. Potem przepuściliśmy przez nie pięć dni rzeczywistych logów.
31%
mniej żądań uruchamiających PrestaShop
93%
mniej wejść w strony z filtrami
0
zablokowanych przeglądarek klientów i żądań integracji
1400 z 1411
odciętych żądań w czasie serii, która wywołała błędy 500
Kolejne kroki to filtr statusów w integracji, ochrona przed scraperami przez CDN z limitem żądań i przekierowania 301 dla martwych adresów.
W pierwszym sklepie problematyczne parametry były częściowo wykluczone w robots.txt, ale nie zatrzymało to crawlera, bo zakodowane i zagnieżdżone parametry nie pasowały do wzorców. W drugim robots.txt w ogóle nie obejmował filtrów, a scraper i tak by go zignorował.
Plik robots.txt jest wyłącznie zaleceniem. Ma sens jako tani pierwszy filtr dla robotów, które go przestrzegają, ale ruch zagrażający dostępności sklepu trzeba ograniczać na poziomie:
Sama liczba wizyt nie wystarczy. W obu przypadkach najwięcej powiedziały te wskaźniki:
Szczególnie niepokojący jest bot, który wysyła dziesiątki tysięcy żądań, z których prawie każde trafia pod inny adres. To typowy sygnał pułapki indeksacyjnej.
Większy serwer ukryłby oba problemy na jakiś czas, ale za zbędny ruch płaciłoby się dalej. Najpierw warto odciąć to, czego klienci nie potrzebują:
| Obszar | Problem | Co pomaga |
|---|---|---|
| Ruch botów | Crawlery i scrapery uruchamiają pełne strony sklepu | Blokady w serwerze WWW, CDN z limitem żądań, WAF |
| Adresy URL | Parametry tworzą nieskończone warianty stron | Poprawne łączenie parametrów, nofollow na przełącznikach, 410 dla śmieciowych adresów |
| Filtry i sortowanie | Każda kombinacja to ciężkie zapytania | Filtry zamknięte dla botów, lista dozwolonych sortowań, cache modułu filtrów |
| Integracje | Częste pobieranie pełnych list przez API | Rzadsze odpytywanie, filtr statusu lub daty, odchudzenie odpowiedzi API po stronie sklepu |
| Martwe adresy | 404 i tymczasowe przekierowania ściągają roboty | Przekierowania 301 do odpowiedników, 410 dla usuniętych stron |
| Logi | Szum deprecjacji ukrywa prawdziwe błędy | Wyłączenie E_DEPRECATED na produkcji, rotacja logów, naprawa modułów |
| Hosting | Limit połączeń z bazą kończy się błędem 500 | Monitoring, a zmiana planu dopiero po usunięciu zbędnego ruchu |
Crawler nie musi być agresywny, żeby przeciążyć sklep. Wystarczy, że aplikacja udostępnia mu bardzo dużo dynamicznych wariantów adresów albo że integracja co chwilę prosi o więcej danych, niż potrzebuje. Każde takie żądanie uruchamia kosztowne zapytania PrestaShop.
Dlatego przy diagnozie wysokiego obciążenia warto pytać nie tylko, który bot wszedł na stronę, ale przede wszystkim:
Dlaczego sklep dał mu tyle pracy i ile z tej pracy było potrzebne klientom?
Optymalizacja PrestaShop zaczyna się od logów, nie od większego serwera. Jeśli potrzebujesz pomocy przy sklepie, zobacz, jak budujemy i rozwijamy sklepy internetowe.
Wolisz to samo bez żargonu?Przełącz na wersję prostą ↑
Przeanalizujemy logi serwera i wskażemy, co realnie obciąża sklep i bazę danych, zanim zdecydujesz o droższym hostingu. Zadzwoń, napisz albo zostaw wiadomość w formularzu poniżej.
Case study optymalizacji PrestaShop: boty, filtry i integracja przeciążały bazę danych i dawały błędy 500. Diagnoza z logów, reguły .htaccess i efekty.
PrzeczytajJak bank spółdzielczy z Inowrocławia buduje relacje z lokalną społecznością: rodzinny inoPiknik, gra edukacyjna dla dzieci i kampania w social mediach.
PrzeczytajJak wyprzedaliśmy bilety na koncert dwa tygodnie przed terminem: niemal 30 000 zł sprzedaży przy budżecie 474 zł. Kampania w social mediach - wyniki.
Przeczytaj